让语言模型更新 README,它可以建议你写些什么。再给它工具,以及负责执行工具的程序,它就能操作真实文件。
我们跟着一个例子看下去:“看看这个项目,更新一下 README。”不用先读代码,也可以理解接下来会发生什么。
1. 把决策接到行动上
先准备三个部分:模型、工具,以及对话记录。程序把任务、相关指令、当前历史和可调用工具的说明发给模型。
模型可能会请求列出项目目录。工具请求只是一个待执行的动作,并不代表动作已经发生。程序检查请求,在允许的情况下执行工具,再记录返回结果。
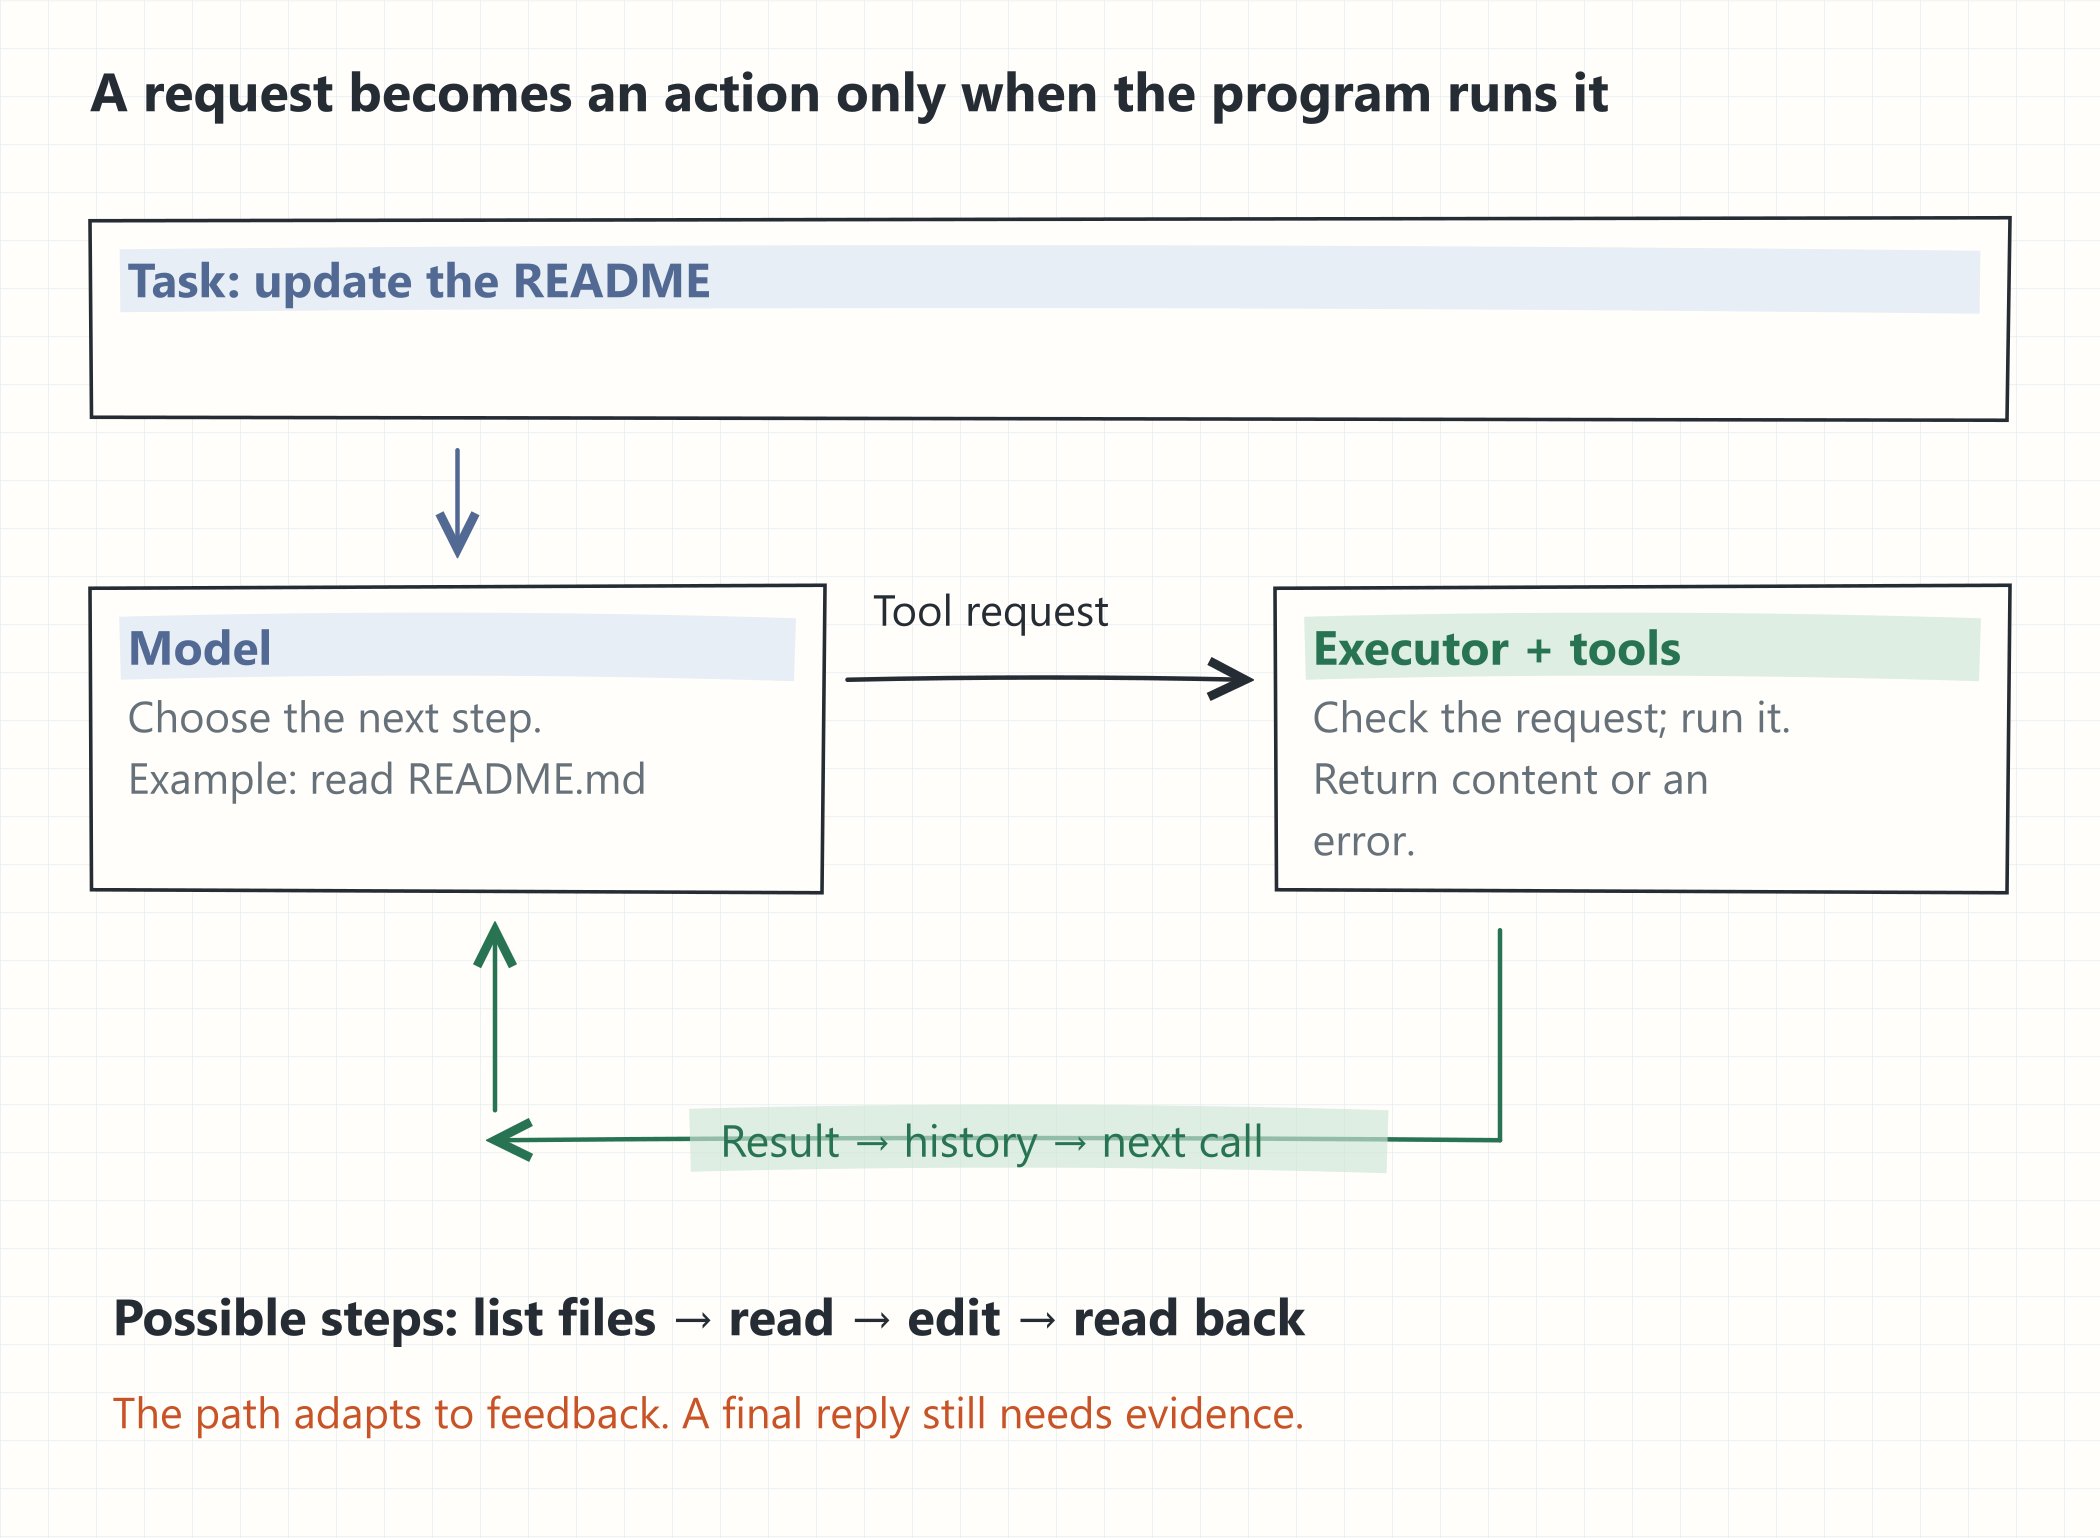
工具结果连同更新后的历史一起交回模型。模型就能根据真实存在的文件,选择下一步。
对于这个任务,一种可能的顺序是:列出文件 → 读取 README 和相关项目文件 → 编辑 README → 再读一遍,检查改动。模型会根据新信息选择步骤;这只是一种示例,并不是固定脚本。
失败的工具调用也能提供信息。看到“文件不存在”,模型可能会转而搜索目录,而不是继续尝试同一个路径。
重复这个过程,直到模型不再请求新的动作。程序也应当能在取消、出错或达到步数上限时停止。最终回复并不能证明任务成功:修改后的文件和检查结果,才是依据。
2. 让行动能够协调,也能被中断
写第一个 Agent 时,逐个执行工具就够了。如果以后要并发执行,就需要保护共享资源。两个操作同时编辑一个文件,可能互相干扰。
一种做法是为每个文件的写入和编辑操作使用共享锁,避免受保护的操作重叠执行。不过,锁不会替你决定正确的编辑顺序,也保护不了绕过这套机制进行的外部修改。
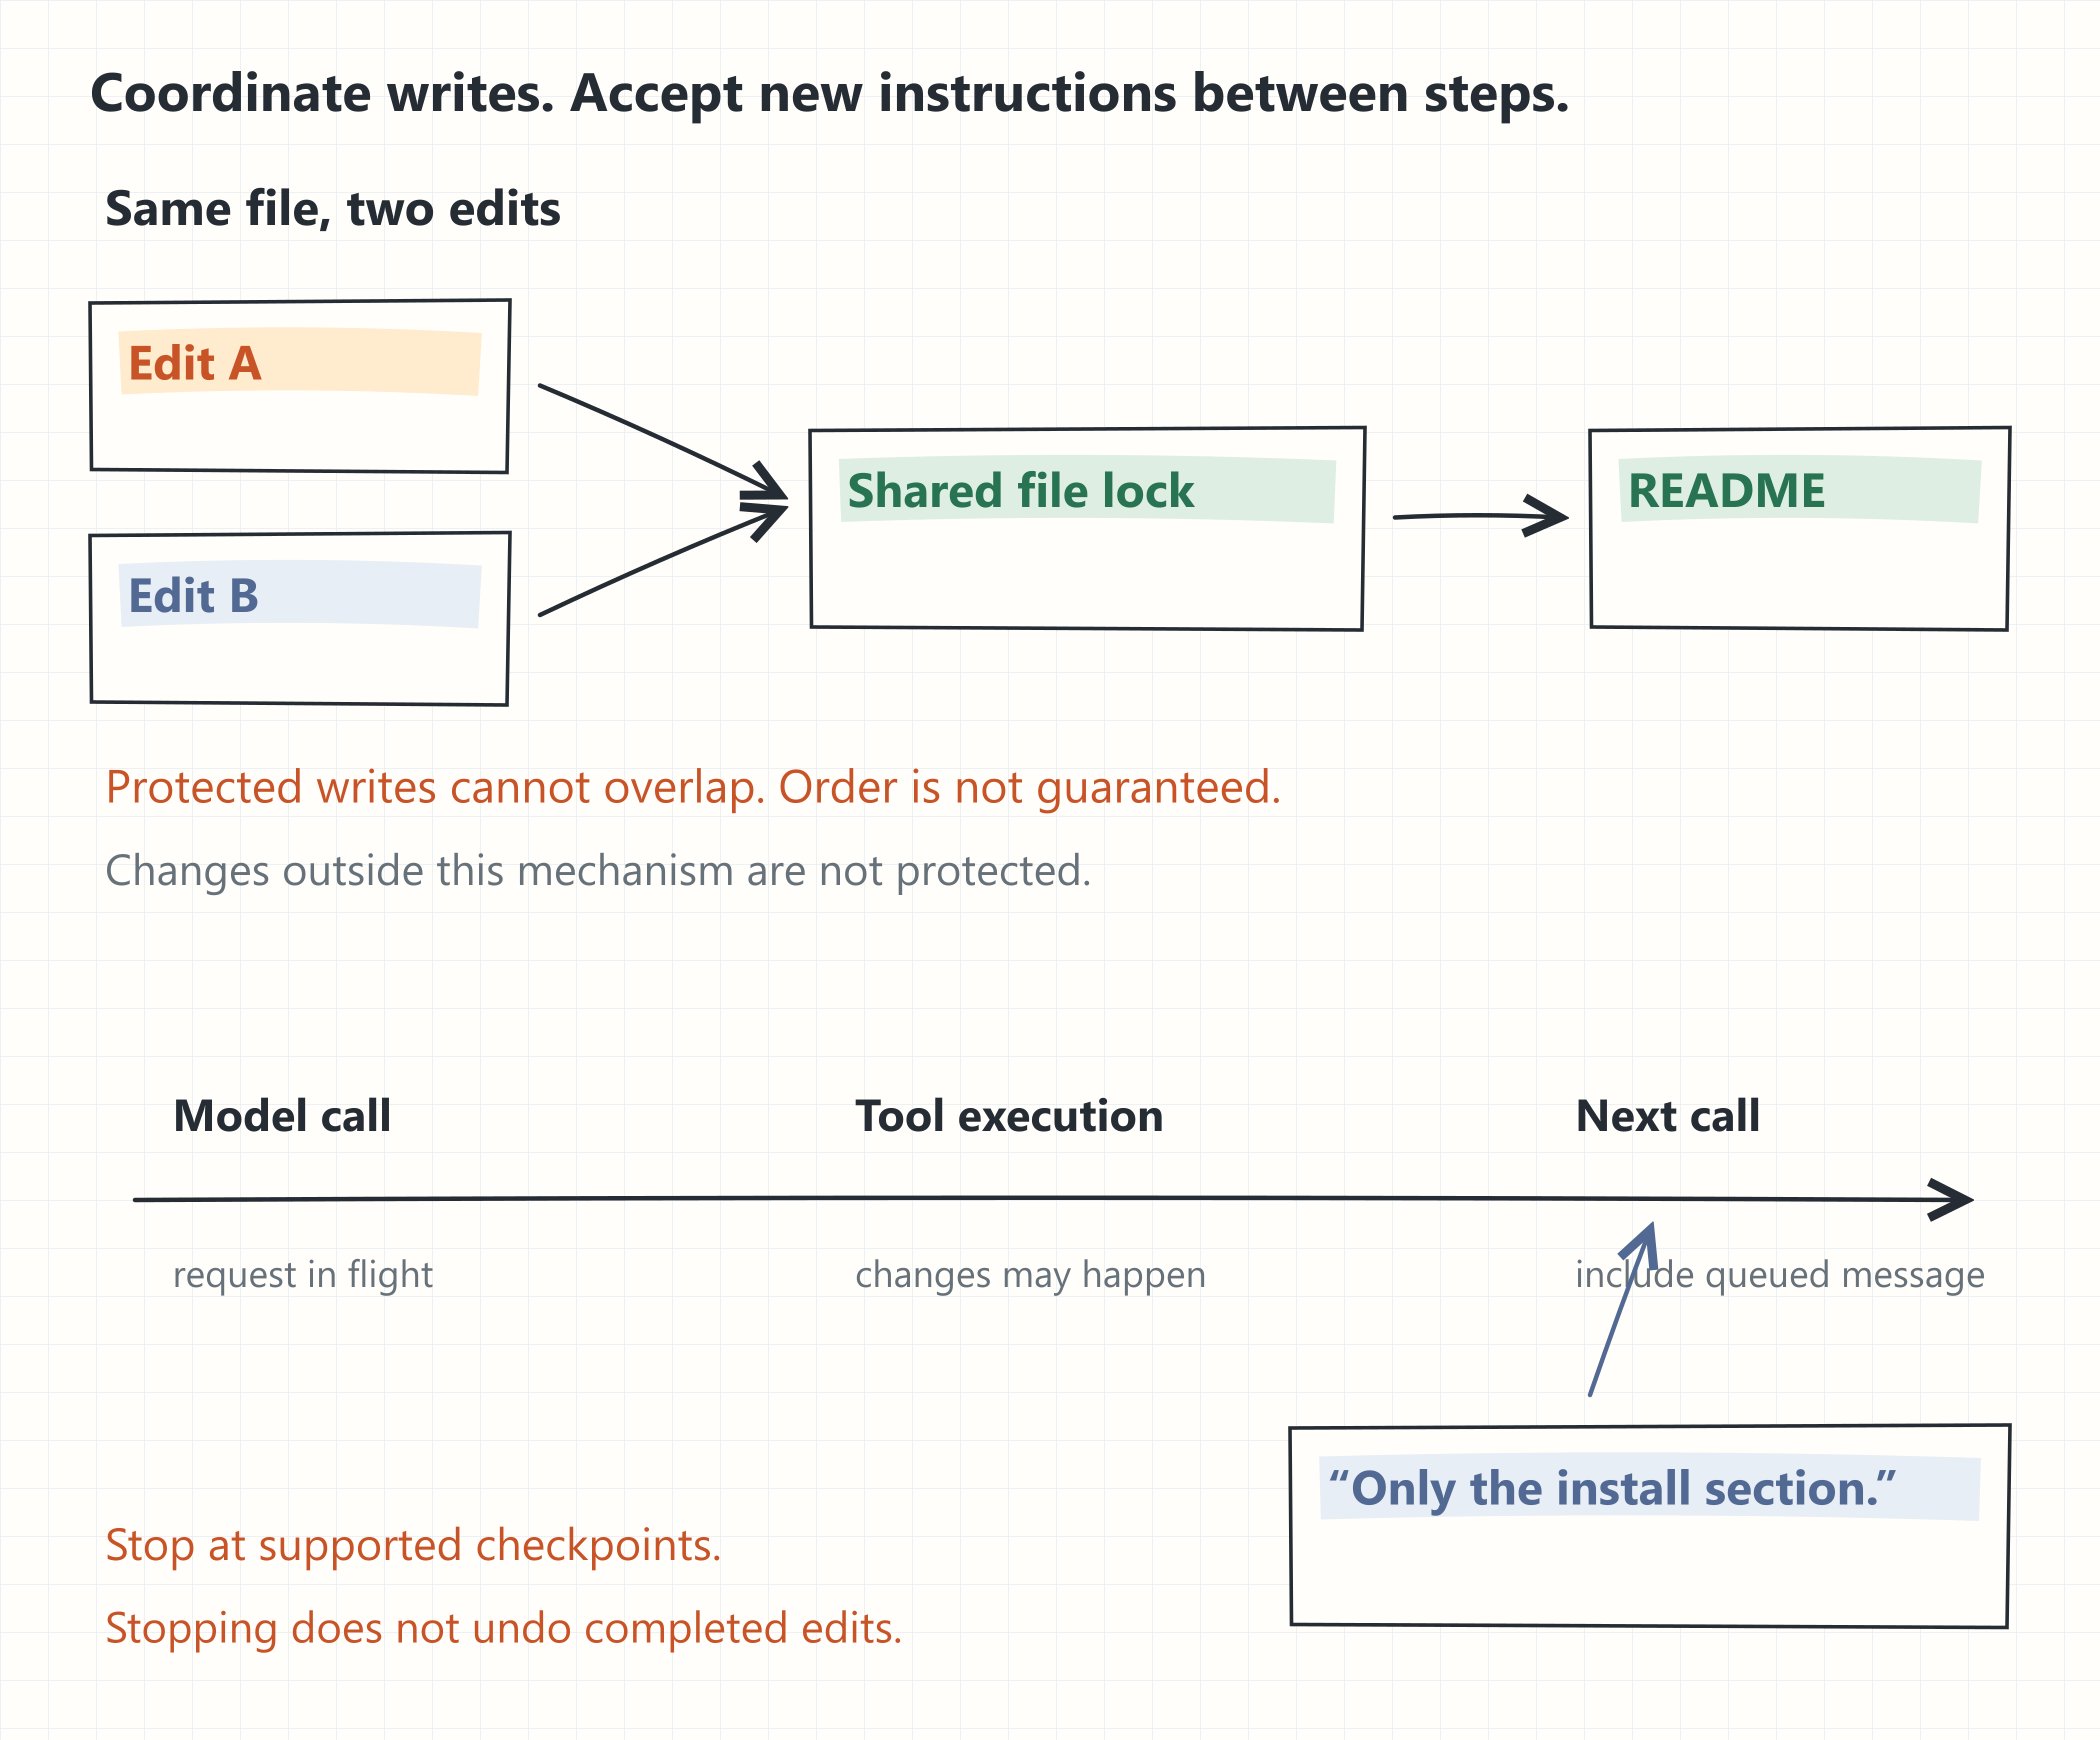
假设用户补充了一句:“只更新安装说明。”程序可以先把指令排入队列,在下一次调用模型之前加入上下文。它无法改变已经发出去的请求,因此 Agent 可能需要重新检查或修正之前的工作。
停止也需要单独的机制。程序可以在步骤之间检查取消信号;要中止正在执行的请求或命令,还需要执行器支持。无论是哪种情况,停止都不会撤销已经完成的改动。
历史中的工具请求和结果应当保持配对,必要时也要记录错误或取消结果。下一步决策需要一份前后一致的工作记录。
3. 给下一步足够的上下文
在一种简单的逐次请求设计中,程序每次调用模型时都会提供对话历史,让模型知道之前学到了什么、做过什么。
把历史保存下来,就能在之后的会话中重新加载对话。但这不等于恢复一个暂停的进程,也不会还原旧文件内容。如果项目可能已经发生变化,就需要重新检查。
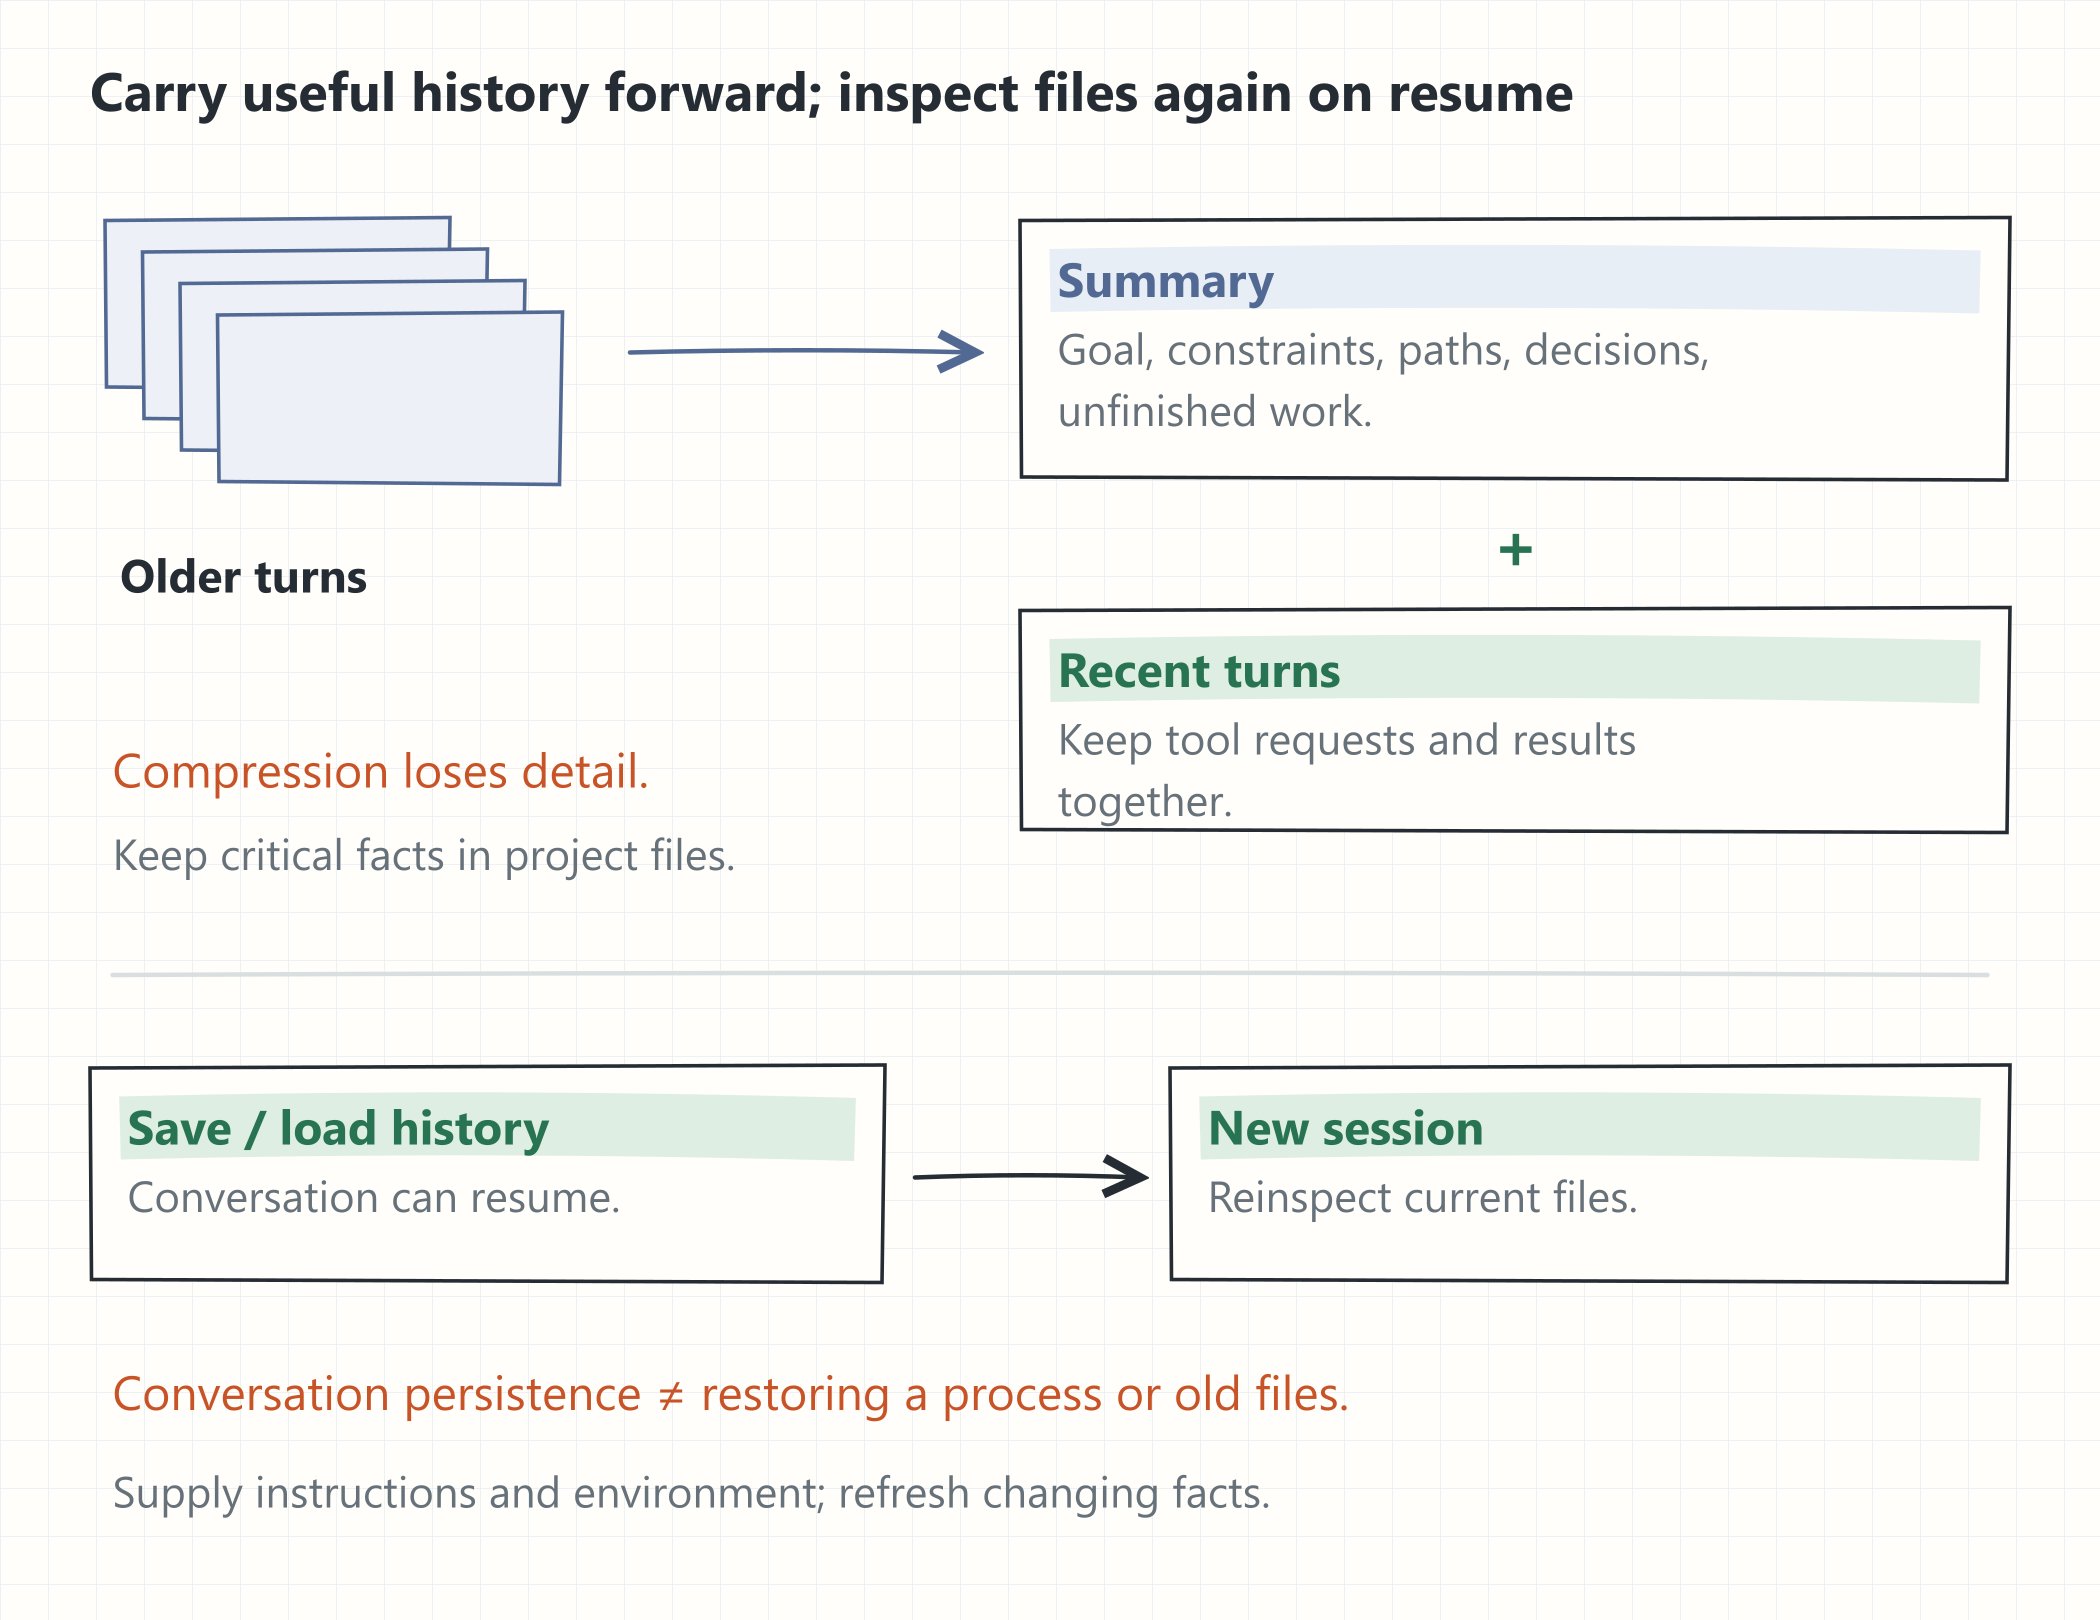
历史越来越长时,可能超出模型的上下文窗口。一种策略是总结较早的工作,同时详细保留最近的交互。保留下来的工具请求与结果,仍然要放在一起。
有用的摘要应当包含目标、约束、准确路径、已经作出的决定和未完成事项。不过,摘要仍然会丢失信息,也可能包含错误。关键事实应当写进项目文件,需要时重新核对细节。
指令补上了另一部分背景:解释工具、工作环境和任务约束。可复用的指导可以放在独立文件里,相关时再加入上下文。对于会变化的事实,应当重新获取,而不是假设它们始终有效。
从小处开始
从一个只读任务和一个工具开始,观察工具输出怎样影响模型的下一步行动。然后,再根据需要加入编辑、检查、中断和持久化。
核心模式一直相同:选择行动,执行行动,观察结果,再作决定。可靠性来自围绕这个循环的设计:清晰的工具、受控的执行、有用的上下文,以及能够证明目标完成的依据。
想看看这些部分在代码里怎样配合?我用 Python 标准库做了 mini-agent 这个学习项目,并配套写了中英文教程。可以读读实现,也试着动手写一个: