今天看了
25年的一篇
Fate: Fast Edge Inference of Mixture-of-Experts Models via Cross-Layer Gate
这篇论文
记录一下。
背景问题是LLM Offloading
关键问题就是
1、模型很大 2、kv缓存也很大 3、还有一些计算的中间张量
但是
4、显存很贵,特别是消费级/端侧显卡放不下
不过
5、同一时间不是所有的参数都要被使用的 6、RAM和SSD相对便宜 7、用较慢但廉价的大容量存储,作为 GPU 显存的二级缓存与后备仓库
附上 AI 整理的表格
存储层级 典型容量 典型带宽 成本 GPU HBM/VRAM(显存) 8 GB ~ 80 GB 1~3 TB/s 极其昂贵 Host CPU RAM(内存) 64 GB ~ 1 TB+ 50~200 GB/s 相对廉价、易扩容 NVMe SSD(固态硬盘) 1 TB ~ 8 TB+ 3~7 GB/s 极其廉价
7、Offloading的核心逻辑是
存放:把完整的模型权重存放在 Host CPU 内存或 SSD 中。
驻留:GPU 显存只保留绝对必要的部分(如 Embedding 层、Dense 注意力层、当前正在计算的层、以及一部分高频访问的缓存)。
搬运与换入换出:在 GPU 计算流向某一模块前,通过 PCIe 总线将对应的权重异步/动态传输(Prefetch/Load)到 GPU;用完后释放或逐出(Evict),为后续参数腾出显存空间。
8、问题是PCIe传输带宽瓶颈,也就是太慢了,如果每一层计算都要等cpu传过来,可想而知推理速度会慢很多
GPU 的计算速度极快(TFLOPS 级别),但 PCIe 带宽(如 PCIe 3.0 仅 16GB/s,PCIe 4.0 为 32GB/s)相对于 GPU 内部显存带宽(数 TB/s)极为缓慢。
9、特别的,针对MoE架构,下一层需要用到哪几个专家完全取决于当前 Token 的动态 Gating 结果
所以不像dense模型,后面要用什么是固定的。
这里放一下之前整理的ds v2的MoE的Gating公式,Gating的公式不同模型不一样,但是这个【下一层需要用到哪几个专家取决于当前 Token的动态Gating】是固定的
Gating 公式
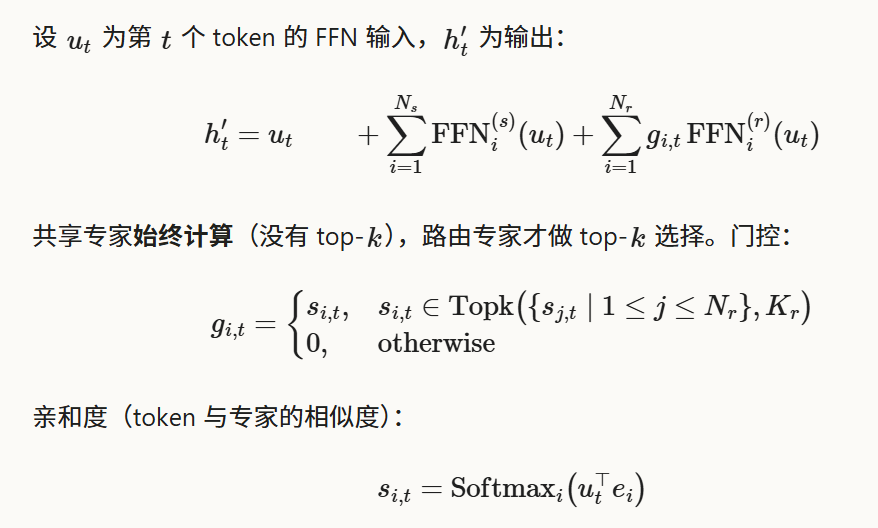
论文主要解决的就是这个问题
主要innovation是:
1、依赖余弦相似度的跨层专家预取
在计算第i层的MoE的时候,就把输入表征复制给cpu,喂入第 $i+1$ 层的 Gate 权重中进行并行预测计算。(再加一点冗余)也就是论文中的置信度扩展策略,拉取置信度超过 75% 分位数的候选专家
观察:
相邻两层 MoE 之间的输入表征具有很高的余弦相似度($Gate\_in_i$ 与 $Gate\_in_{i+1}$ 相似度达88.83%)
相邻层 Gate 输出的概率分布高度相似,即使 Top-k 排序略有偏差,目标专家往往也排在第 5、6 位。Fate 通过拉取置信度超过 75% 分位数的候选专家,将解码阶段的预取准确率从 78.79% 提升至 97.15%。
2、浅层偏好专家缓存(Shallow-Favoring Expert Cache):
使用分层缓存分配策略
在给定的显存预算(memory_budget)扣除 Dense 权重和 KV Cache 后,计算可缓存专家总数 cache_total,设定浅层分界线 $L$(如 Qwen1.5-MoE 设为 $L=3$),优先把 GPU 缓存配额分配给浅层的专家。深层剩余缓存空间则均分。
也就是说浅层不好预测,所以尽可能优先存在显存里面,深层好预测,就可以放到RAM/SSD里面调度了。
据说此举直接将整体专家缓存命中率提升至 99.08%。
观察:
- 层级路由特性差异:浅层(如 0~3 层)的专家路由权重较为平坦/均匀(Token 没有明显的专家偏好),导致预取准确率较低;而深层的专家偏好十分明确,预取准确率接近 100%。
3、专家量化管理(Quantization for Cache & I/O)和阶段针对性的计算与 I/O 流水线重叠(Pipeline Overlapping)
这俩就没啥创新,用的基本都是现有的思路,主要就是按需量化和流水线设计。
接下来再结合ai整理了一下这个llm offloading领域最近的几个主流方向。肯定有不完善之处,后续再优化。
1、算法与系统co-design
例如
SMoE: An Algorithm-System Co-Design for Pushing MoE to the Edge via Expert Substitution
**发表:**ISCA 2026(计算机体系结构顶级会议)
痛点观察:传统卸载为了几个打分极低的长尾专家频繁发生 PCIe 传输,严重拖慢整体流水线。
专家替代(Expert Substitution):根据门控得分动态区分专家重要性,对于打分极低、对输出影响微乎其微的激活专家,直接用当前已缓存在 GPU 显存中的同质闲置专家替代执行,从而彻底避免低价值专家的 PCIe 搬运。
协同流水线:结合高分专家预测预取和两指针 CPU 辅助调度算法,将端侧 MoE 解码延迟降低了约 48%。
CommitMoE: Efficient Fallback-Free MoE Inference with Offloading
- 发表:AAAI 2026 / 2025
- 核心思想与机制:
- 消除回退惩罚(Fallback-Free):传统预取方案在预测失败时会触发昂贵的同步 Fallback 加载;CommitMoE 发现门控确定性与预测准确率强相关,而在低确定性场景下模型本身对专家选择具备天然鲁棒性。
- Commit Router:无条件采纳预测出的专家列表进行计算,杜绝任何运行时的二次按需传输,从根本上消除了预取失败带来的双重 I/O 延迟。
2、 投机与分摊(Speculative & Amortized Offloading)
SpecMoE-Off & MoE-SpeQ
思想与机制:
- 投机块调度(Speculative Chunking):引入轻量级 Draft 模型连续推测未来多个 Token 的专家需求图谱,将原本离散的高频小粒度传输合并为大块 DMA 批量传输,掩盖了高达 2.5x 的专家传输延迟。
- 摊销屋顶模型(Amortization Roofline Model):通过建立量化传输-计算窗口的屋顶模型,自适应动态调节推测窗口大小,使得 PCIe 总线与 GPU 计算单元实现理论最优饱和度。
3、极致量化与就地协同计算(Heterogeneous Compute-in-Place)
CoMoE / MoE-MPMC 系列
- 发表会议:MLSys / EuroSys 2025–2026
- 核心思想与机制:
- 异构算力就地计算(Compute-in-Place):改变了“必须把权重搬运到 GPU 显存”的传统思路,将频繁使用的核心专家常驻在 GPU 显存(INT4/FP8),而长尾冷门专家常驻在 CPU/NPU 内存端,直接在 Host 端完成 GEMM 矩阵乘法并仅回传激活值,避免千兆字节权重的总线搬运。
- 动态多生产者-多消费者流水线(MPMC):使用专门的轻量级循环单元线程与推理线程异步并发,动态完成多副本与容量受限管理。
4、更好的缓存替换
淘汰单纯依赖单步局部特征的 ARC / LRU 策略,转向长文本任务拓扑感知等更好的调度策略